Free tools Windows power users keep installed
One-click scans. No signup required.
Some links on this page are affiliate links: if you buy through them we may earn a commission, at no extra cost to you.
Короткий ответ: единого официального установщика DeepSeek для Windows, macOS и Linux нет. Онлайн-версия работает на chat.deepseek.com, а для локального запуска на компьютере устанавливают стороннюю программу-рантайм — Ollama или LM Studio — и отдельно скачивают модель DeepSeek.
Для новичка проще всего LM Studio с графическим интерфейсом. Ollama лучше подходит для терминала, автоматизации, разработки и локального API.
Что именно устанавливается
Под названием «приложение DeepSeek» обычно смешивают несколько разных продуктов:
Recommended Free Tools
- Официальный веб-чат — облачный сервис, который открывается в браузере и требует интернет.
- Официальный API DeepSeek — вариант для программ и сервисов через platform.deepseek.com.
- Локальная модель — скачанные веса DeepSeek, которые обрабатываются на вашем компьютере.
- Ollama или LM Studio — не официальные приложения DeepSeek, а инструменты для запуска опубликованных моделей.
После загрузки модели локальный чат может работать без интернета. Однако обновления, поиск моделей, плагины, облачные функции и внешние интеграции могут использовать сеть.
#1 Best Overall

- EVOLUTION RYZEN AI MAX+ 395 MINI PC - GMKtec EVO-X2 is the next evolution in AI mini PC Ryzen Strix Halo series. Thanks to AMD Simultaneous Multithreading (SMT) the core-count is effectively doubled, to 32 threads. Ryzen AI Max+ 395 has 64 MB of L3 cache and can boost up to 5.1 GHz, depending on the workload. The Ryzen AI Max+ 395 is currently rated as the "most powerful x86 APU" on the market for AI computing.
- AI NPU with XDNA 2 ARCHITECTURE - Powered by 16 “Zen 5” CPU cores, 50+ peak AI TOPS XDNA 2 NPU and a truly massive integrated GPU driven by 40 AMD RDNA 3.5 CUs, the Ryzen AI MAX+ 395 is a transformative upgrade and delivers a significant performance boost over the competition. The Ryzen AI Max+ 395 excels in consumer AI workloads like the llama.cpp-powered application: LM Studio. Shaping up to be the must-have app for client LLM workloads, LM Studio allows users to locally run the latest language model without any technical knowledge required and unleash their creativity and productivity.
- AMD RADEON 8090S iGPU GAMING PC - The AMD Radeon RX 8060S offers all 40 CUs with up to 2.9 GHz graphics clock and uses the new RDNA 3.5 architecture. The powerful iGPU is positioned between an RTX 4060 and 4070 laptop GPU and therefore enables gaming in FHD at maximum details in most demanding games. The 8060S can also utilize the full 128GB pool, which is perfect for running LLMs such as Deepseek 70B Q8, which runs comfortably on this machine.
- EIGHT CHANNEL LPDDR5X - LPDDR5X is a new ground breaking memory small form factor installed on-board. With blazing speeds up to to 8000MT/s, it runs 1.5x faster than the DDR5 SODIMMs; 90% better performance over DDR5 SODIMMs in video conferencing and photo editing; 30% better performance in productivity apps; 12% better performance in digital content workloads.
- QUAD SCREEN 8K DISPLAY SUPPORT - EVO-X2 AI Mini PC support 4-screen 4K/8K output via HDMI 2.1 (8K@60Hz), DisplayPort 1.4 (4K@60Hz), and dual USB 4 40Gbps Transfer speed (supporting PD3.0/DP1.4/DATA). Ideal for gaming, video editing, and multitasking, it provides expansive and crisp multi-display support.
Какой способ выбрать
| Задача | Лучший вариант |
|---|---|
| Просто попробовать DeepSeek | Официальный веб-чат |
| Графический интерфейс без терминала | LM Studio |
| Локальный API и автоматизация | Ollama |
| Linux-сервер без рабочего стола | Ollama |
| Apple Silicon и поддержка MLX | LM Studio или Ollama |
| Слабый компьютер | Облачный чат или небольшая локальная модель |
Подготовьте компьютер
Для первоначальной загрузки потребуется интернет и достаточно свободного места на SSD. Модель на диске — это не вся требуемая память: во время работы нужны дополнительные буферы и память под контекст.
| Оперативная память | Практический ориентир |
|---|---|
| 8 ГБ | Небольшие модели; ожидания по скорости и качеству должны быть умеренными. |
| 16 ГБ | Разумная стартовая конфигурация для квантованных моделей класса 7B/8B. |
| 32 ГБ | Больше возможностей для 14B и некоторых 32B-вариантов. |
| 64 ГБ и больше | Крупные модели, но итоговая скорость всё равно зависит от GPU и пропускной способности памяти. |
Это ориентиры, а не официальные системные требования. На результат влияют модель, формат, квантование, длина контекста, процессор, видеокарта и операционная система. Подходящей видеокарты нет — запуск возможен на CPU, но обычно заметно медленнее.
Установка DeepSeek через Ollama
Ollama официально поддерживает macOS, Windows и Linux.
Windows
- Скачайте установщик с официальной страницы Ollama.
- Запустите файл и завершите установку.
- Откройте Windows Terminal или PowerShell и проверьте команду:
ollama --versionЗапустите модель:
ollama run deepseek-r1Ollama скачает выбранную модель и откроет диалог в терминале. Если текущая библиотека Ollama предлагает конкретные теги или размеры, выберите тег со страницы модели: названия доступных вариантов могут меняться.
Список установленных моделей:
ollama listОбычная установка Ollama на Windows не требует WSL. Защитник Windows или корпоративный антивирус иногда блокирует локальный сервер или его порт.
macOS
Для Ollama требуется macOS 14 Sonoma или новее. На Apple Silicon используются возможности чипов Apple M; Intel Mac работает только в CPU-режиме. Подробности приведены в документации Ollama для macOS.
- Скачайте Ollama с официальной страницы.
- Откройте
ollama.dmgи перетащите приложение вApplications. - Запустите Ollama. При необходимости разрешите создание CLI-ссылки.
- В Terminal выполните:
ollama --version
ollama run deepseek-r1
Модели и конфигурация по умолчанию хранятся в ~/.ollama, а журналы — в ~/.ollama/logs. Не переносите отдельные файлы вручную: способ изменения каталога хранения зависит от текущей версии Ollama, поэтому используйте актуальные настройки и документацию.
Linux
Официальный способ установки описан на странице Ollama для Linux:
Rank #2
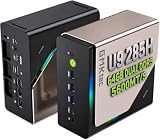
- EVOLUTION CORE ULTRA 9 285H MINI PC - GMKtec EVO-T1 is the next evolution in AI mini PC Ultra 9 series. The Core Ultra 9 285H offers 16 cores (six P-cores + eight E-cores + two LPE-cores) and 16 threads with a turbo clock of 5.4 GHz. It is currently one of the best value for performance AI mini PC computers.
- AI NPU - The 285H features an Intel AI Boost NPU, capable of up to 13 TOPS (Tera Operations per Second) for INT8 calculations, which is designed to accelerate AI tasks.
- INTEL ARC 140T GAMING PC - The Arc 140T GPU includes 8 Xe cores and supports features like DirectX 12, OpenGL 4.5, and OpenCL 3, making it capable of handling modern games and creative applications. It also supports Quick Sync Video for efficient video encoding and decoding, as well as AV1 encoding and decoding.
- 64GB DDR5 RAM + 1TB SSD - The EVO-T1 is equipped with Dual 32GB (Total 64GB) SO-DIMM DDR5 5600MHz memory sticks. 2TB PCIE 4.0 SSD Drive with 3x M.2 2280 Expansion slots. Each slot capable of reading up to 4TB. (12TB MAX)
- QUAD SCREEN 8K DISPLAY SUPPORT - EVO-T1 AI Mini PC support 4-screen 4K/8K output via HDMI 2.1 (8K@60Hz), DisplayPort 1.4 (4K@60Hz), and USB Type-C Transfer speed (supporting PD3.0/DP1.4/DATA). Ideal for gaming, video editing, and multitasking, it provides expansive and crisp multi-display support.
curl -fsSL https://ollama.com/install.sh | shКоманда передаёт официальный скрипт оболочке на выполнение, поэтому запускайте её только после проверки адреса источника. Затем:
ollama --version
ollama run deepseek-r1
Если Ollama установлена как systemd-служба, её состояние можно проверить так:
Outdated Drivers Are Slowing You Down
One free scan finds every outdated or missing driver and matches the right update for your exact hardware.Free scan · exact hardware matchWindows Errors? Fix Them Before They Spread
Repair common Windows errors and clear accumulated junk for a smoother, more stable PC - no reinstall needed.Free scan · no reinstallsystemctl status ollamaПри необходимости запустите службу:
sudo systemctl start ollamaЭто типичный сценарий для systemd-дистрибутивов, а не универсальная команда для каждого варианта Linux. Ускорение на NVIDIA зависит от драйверов и поддержки CUDA; для AMD и Intel всё также определяется версией Ollama, драйверами и видеокартой.
Проверка локального API Ollama
Локальный сервер Ollama обычно доступен по адресу http://localhost:11434. Проверить список моделей можно командой:
curl http://localhost:11434/api/tagsПример запроса к чату:
curl http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1",
  "messages": [{
    "role": "user",
    "content": "Объясни, что такое локальная языковая модель."
  }]
}'
Перед выполнением убедитесь, что имя модели совпадает с результатом команды ollama list.
Do these 3 things before closing this tab:
1Fix the driver behind crashes, sound loss and screen glitches2Clear out junk files and repair common Windows errors3Scan for outdated or missing drivers - takes under a minuteУстановка через LM Studio
LM Studio — графическое приложение для Windows, macOS и Linux. Оно поддерживает модели DeepSeek в формате GGUF через llama.cpp, а на Apple Silicon также модели MLX.
- Скачайте LM Studio с официального сайта.
- Установите приложение для своей операционной системы.
- Откройте каталог моделей и найдите
DeepSeek R1или нужный дистиллированный вариант. - Выберите файл и квантование, затем дождитесь загрузки.
- Откройте раздел чата, загрузите модель в память и отправьте тестовый запрос.
Для управления рантаймами LM Studio документирует сочетания Command + Shift + R на Mac и Ctrl + Shift + R на Windows/Linux. На сервере без графического интерфейса можно рассмотреть headless-вариант llmster, но для такого сценария Ollama обычно проще.
Как выбрать файл и квантование
- GGUF — распространённый формат для локального запуска через
llama.cpp. - MLX — дополнительный вариант для Apple Silicon в LM Studio.
- Q4 обычно требует меньше памяти, чем Q8.
- Более сильная квантизация уменьшает размер и требования, но может снизить качество.
Для первого запуска разумно выбрать квантованную модель класса 7B/8B. Если программа завершается или работает слишком медленно, перейдите на меньшую модель или более лёгкое квантование.
Rank #3

- 【Low Power for Always-On AI Workflows】At just 15W TDP, the GEEKOM A7 uses far less power than a traditional 350W desktop, helping reduce electricity costs, heat, and cooling noise during extended operation. That efficiency makes it ideal for keeping cloud AI assistants and AI Agent tasks running in the background—automating document summaries, email polishing, meeting notes, content rewriting, research, and scheduled workflows throughout the day. The energy savings can help recoup the device cost in about 1 year, making A7 a practical choice for 24/7 AI task hosting and efficient everyday computing.
- 【Ryzen 7 7730U – More Than a Low-Power PC】Think low power means less performance? Not here. The Ryzen 7 7730U mini computer packs 8 cores, 16 threads, and up to 4.5GHz, giving you the power to handle multitasking, dozens of tabs, video calls, and creative work smoothly. AMD Radeon Graphics supports 4K playback, multi-display work, photo editing, and casual gaming without a dedicated GPU. Compared with the Ryzen 7 5825U and Ryzen 5 7430U, it delivers up to 20% higher performance for faster response and smoother everyday computing—all in a compact, energy-efficient Mini desktop.
- 【Lock In More Memory Before It Costs More】32GB gives you the headroom most demanding tasks need today—and room to grow tomorrow. Built for heavy multitasking, content creation, large projects, and AI-assisted workloads, the GEEKOM mini pc starts you with twice the memory of a typical 16GB setup, so you can skip an immediate upgrade. With AI driving greater demand for memory, starting with 32GB is a smarter way to stay ready for what’s next. The 500GB PCIe Gen4 x4 SSD delivers fast storage, with support for up to 64GB RAM and 4TB SSD storage when you need more.
- 【Premium Metal Design & 3-Year Warranty】Why settle for plastic? The GEEKOM mini desktop features a premium aluminum alloy chassis that resists daily wear and helps dissipate heat during extended use. Rigorous quality testing and CE, FCC, and RoHS compliance support dependable performance, backed by a 3-year limited warranty and professional support for long-term peace of mind.
- 【One Mini PC, All Your Ports】Stay connected with dual USB-C ports, 5 USB 3.2 ports, dual HDMI 2.0, and a 2.5G LAN port for fast, flexible connectivity. The USB-C ports support high-speed data transfer, display output, and peripheral power, while Wi-Fi 6E keeps streaming, file transfers, and online work fast and reliable. From multiple peripherals to high-resolution displays, everything you need stays within easy reach.
Какую модель DeepSeek выбрать
Официальная карточка DeepSeek-R1 перечисляет дистиллированные варианты на базе Qwen и Llama: 1.5B, 7B, 8B, 14B, 32B и 70B. Размер и требования зависят от формата и квантования.
| Размер | Кому подходит |
|---|---|
| 1.5B–3B | Слабым компьютерам и простым задачам; возможности ограничены. |
| 7B–8B | Наиболее разумная отправная точка для обычного ПК. |
| 14B | Более мощным компьютерам, если важнее качество. |
| 32B | Рабочим станциям с большим объёмом RAM/VRAM. |
| 70B и выше | Мощным рабочим станциям или серверной инфраструктуре. |
| Полная R1 | Не подходит большинству домашних компьютеров. |
Полная модель DeepSeek-R1 в репозитории занимает примерно 689 ГБ и содержит сотни миллиардов параметров. Для домашнего ПК обычно выбирают дистилляты и квантованные файлы, а не полный набор весов.
Как убедиться, что работа действительно локальная
- Проверьте, что модель скачана на диск, а приложение показывает локальный runtime.
- Убедитесь, что запрос отправляется на
localhost, а не на удалённый API. - Отключите интернет и выполните простой тест после полной загрузки модели.
- Отключите облачные функции, если они включены. Для Ollama соответствующие ограничения описаны в FAQ.
Локальный inference уменьшает необходимость передавать текст внешнему сервису, но не гарантирует абсолютную приватность всей системы. Телеметрия операционной системы, обновления, плагины и подключённые программы могут иметь собственный сетевой доступ.
Локальный API в LM Studio
LM Studio умеет запускать локальный OpenAI-совместимый сервер. Откройте раздел сервера, загрузите модель, запустите сервер и используйте URL и порт, которые показывает установленная версия приложения. Эти параметры не стоит считать постоянными: копируйте их из интерфейса.
Такой endpoint можно подключить к собственной программе, редактору кода или другому клиенту, поддерживающему OpenAI-совместимый API. Не открывайте локальный сервер в интернет без авторизации, сетевого экрана и понимания последствий.
What’s actually slowing this PC down?
Pick the symptom - the matching free tool is one click away.
Ошибки и решения
| Симптом | Что проверить |
|---|---|
| Не хватает памяти | Закройте приложения, выберите меньшую модель или более сильную квантизацию. |
| Модель запускается, но работает медленно | Возможен CPU-only режим, нехватка VRAM или частичная загрузка в RAM. Уменьшите модель и контекст. |
ollama is not recognized |
Перезапустите Terminal/PowerShell после установки, проверьте ollama --version и запуск приложения из меню Start. |
На Mac нет команды ollama |
Перезапустите приложение и проверьте запрос на создание CLI-ссылки при первом запуске; не создавайте ссылки вручную без необходимости. |
| Linux-установка не сработала | Проверьте curl --version, архитектуру, свободное место, статус службы и логи systemd. |
| Модель не загружается | Проверьте место на диске, удалите повреждённую загрузку, скачайте её заново и при необходимости временно переключитесь на CPU. |
| Антивирус блокирует работу | Проверьте разрешения для приложения и локального порта, особенно на корпоративном компьютере. |
Как удалить DeepSeek
Удаление состоит из двух независимых действий: убрать программу-рантайм и удалить скачанные модели. Если модели могут понадобиться позже, удалите только приложение, сохранив каталог моделей.
- Ollama: удалите модели средствами Ollama, затем удалите приложение штатным способом ОС. Полное удаление также требует очистки пользовательского каталога и логов; перед удалением проверьте актуальные пути в документации.
- LM Studio: удалите приложение через стандартный деинсталлятор Windows/Linux или переместите его в корзину на macOS. Каталог моделей удаляйте отдельно, если нужно освободить диск.
Не выполняйте бездумно команды вроде rm -rf: они могут безвозвратно удалить модели, настройки и журналы.
Онлайн или локально
Облачный DeepSeek удобнее, не требует мощного компьютера и обычно быстрее запускается. Локальный вариант даёт больше контроля над обработкой текста и может работать без интернета, но требует дискового пространства, памяти, настройки и иногда мощной видеокарты. Локальная модель также может отличаться от облачной по качеству, скорости и доступным функциям.
Итоговый выбор прост: новичку стоит начать с LM Studio, разработчику и пользователю командной строки — с Ollama, владельцу слабого компьютера — с официального веб-чата, а для GPU-сервера и продвинутого развёртывания подойдут Hugging Face, vLLM или SGLang. Инструкции и примеры этих движков приведены в карточке DeepSeek-R1; полную R1 не следует устанавливать на обычный ноутбук.
The Tool Desk
Outbyte Driver Updater FREEFix the driver behind crashes, sound loss and screen glitchesFind Drivers →Outbyte PC Repair FREEClear out junk files and repair common Windows errorsFree Scan →Quick Recap
Product prices and availability are accurate as of the date/time indicated and are subject to change. Any price and availability information displayed on Amazon at the time of purchase will apply.

